авг. 27, 2026
Адаптация модели: от промпта к fine-tuning
Данные подключены, но модель отвечает в общем стиле? Разбираем иерархию адаптации: от промпта и RAG до fine-tuning, LoRA и PEFT....
авг. 26, 2026
Data: как дать модели память
Модель может быть очень умной и при этом ничего не знать о вашей компании. Разбираем RAG, embeddings, vector DB и chunking: как дать AI доступ к знаниям компании без дообучения....
авг. 25, 2026
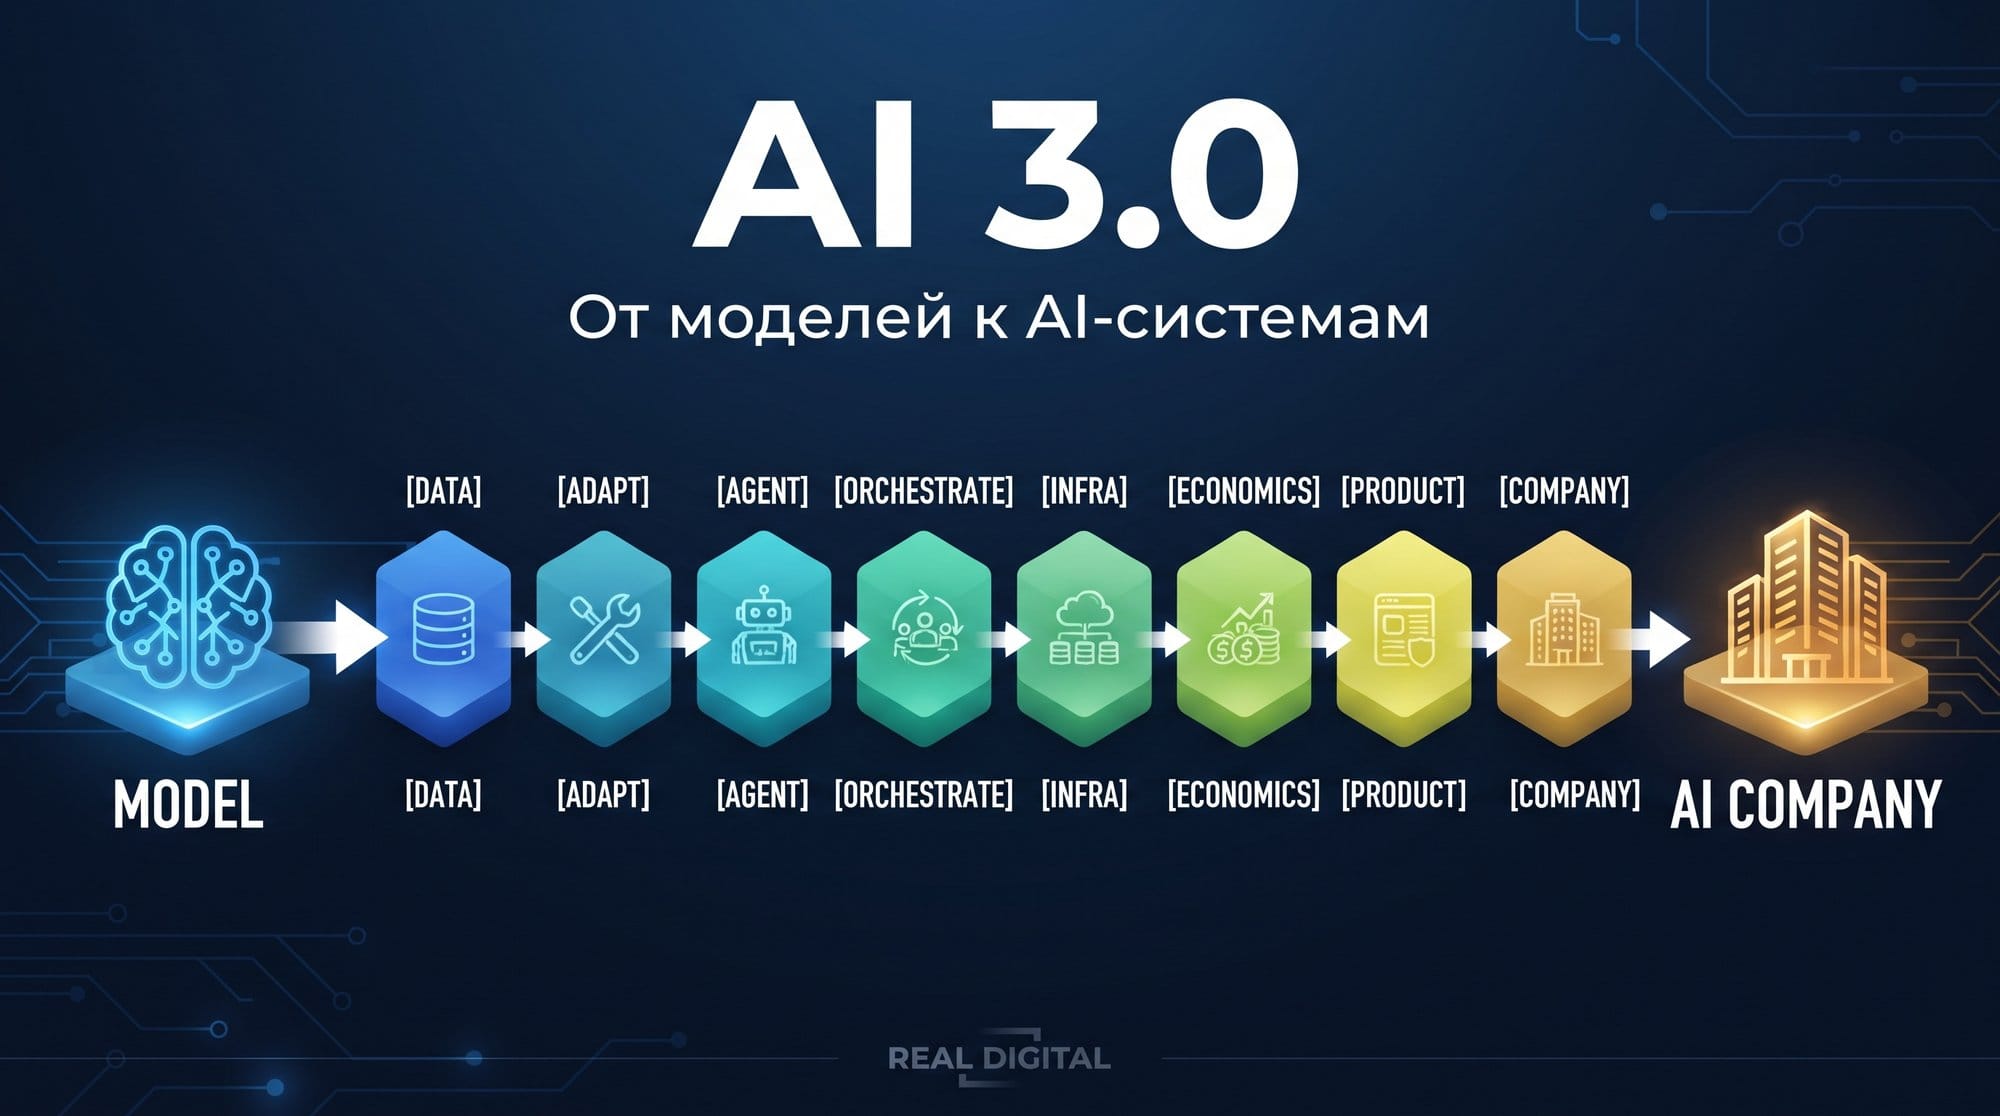
AI Stack: карта для принятия решений
AI-продукт — это не модель. Разбираем, с чего начать: API, свой инференс или edge, и как устроена карта из 8 блоков AI-системы....

авг. 06, 2026
Как модель понимает контекст: механизм Attention
Статья 2017 года «Attention Is All You Need» легла в основу почти всех современных LLM — от GPT до Claude и DeepSeek. Разбираем механизм Attention....
авг. 05, 2026
Что такое Mixture of Experts и почему огромные модели работают быстрее, чем кажется
DeepSeek-V3 весит 671 млрд параметров, но на каждый токен считает только 37 млрд. Разбираем архитектуру Mixture of Experts....
авг. 04, 2026
Что такое дистилляция и почему маленькие модели становятся всё умнее
Дистилляция передаёт знания огромной модели компактной. Модель в 1,5 млрд параметров обгоняет GPT-4o на олимпиадной математике....