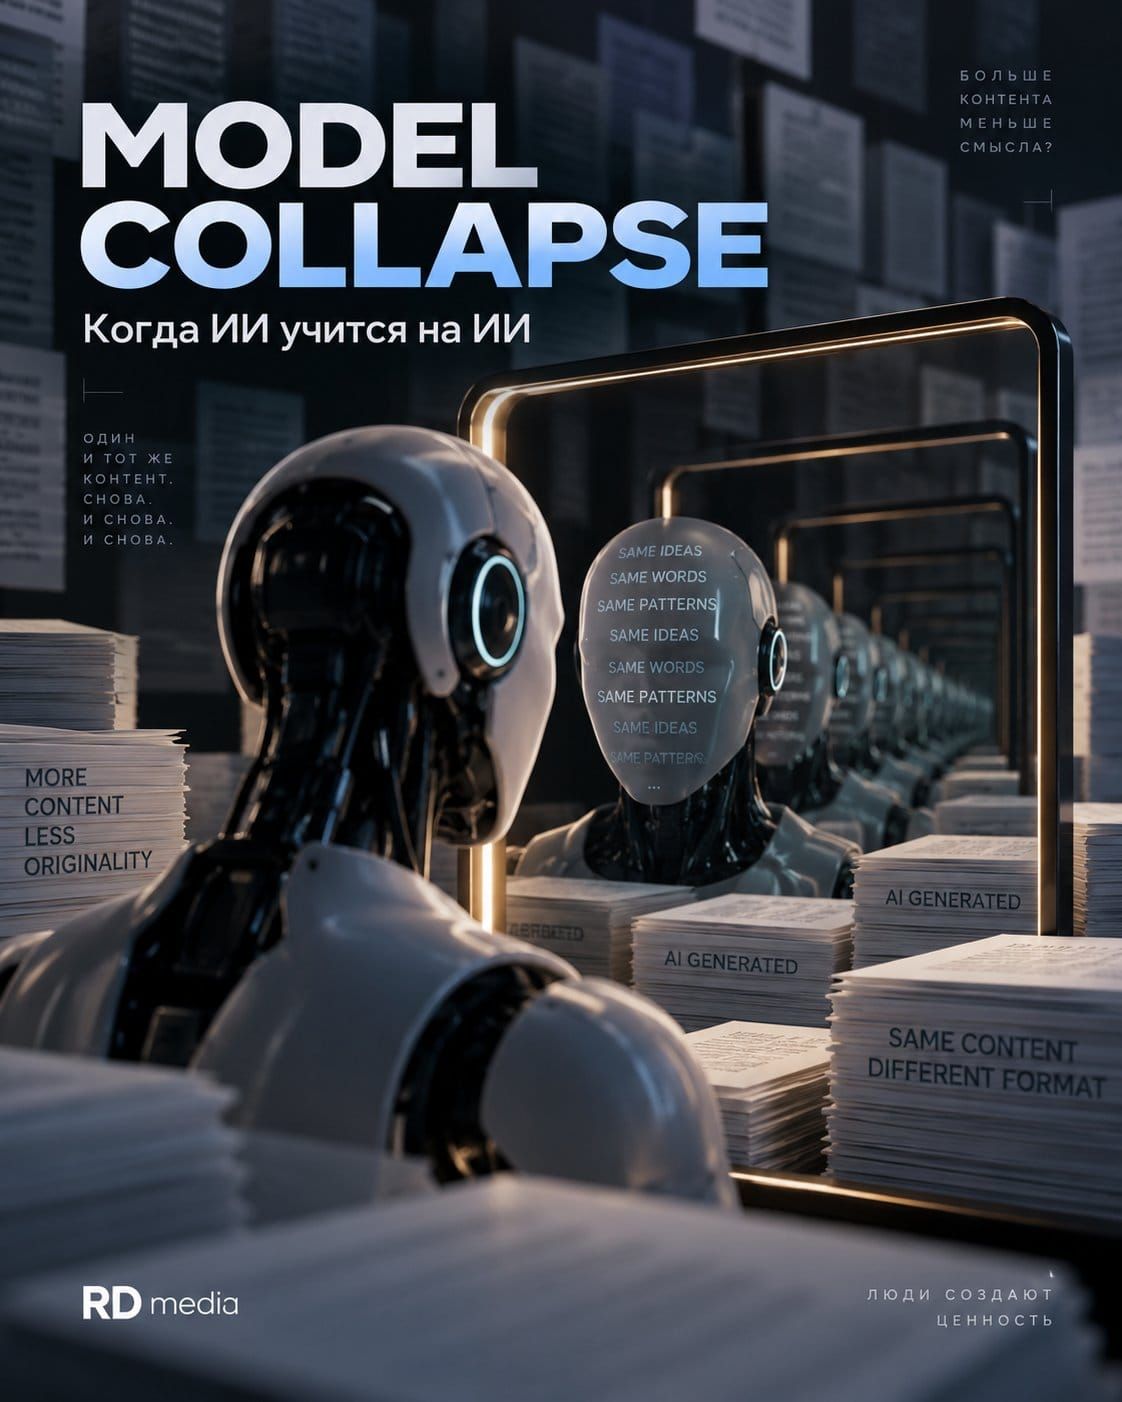
Нейросети стали частью цифрового пространства. Вместе с масштабированием генеративного ИИ возникает парадокс: чем больше AI-контента появляется в интернете, тем выше потенциальная доля синтетических данных в обучающих выборках будущих моделей — и тем важнее становится сохранение исходных человеческих данных.
В 2024 году в Nature вышло исследование Shumailov et al., описавшее эффект model collapse — деградацию модели при рекурсивном обучении на данных, созданных предыдущими поколениями моделей. При последовательном обучении на синтетических данных модели могут терять информацию о первоначальном распределении данных: исчезают редкие и необычные примеры, а ошибки предыдущих поколений начинают накапливаться.
Проблема уже выходит за пределы лабораторий.
Что происходит с интернетом
Пример того, как AI-контент проникает в социальные сети, — исследование компании Pangram Labs (собственные данные компании, независимой рецензии не проходили):
- более 40% longform-постов в LinkedIn в выборке компании определены как полностью AI-generated;
- в среднем по исследованным платформам полностью сгенерированными ИИ оказались около 26% публикаций длиннее 250 слов;
- LinkedIn показал наибольшую долю AI-generated контента среди исследованных платформ.
Это не значит, что интернет «сломался» или весь AI-контент плох. Появляется другая проблема: контент начинает цитировать сам себя.
ИИ создаёт текст → текст попадает в интернет → его используют как данные → следующая модель обучается на нём → создаёт новый текст → цикл повторяется.
Что это означает для маркетинга
В цифровом маркетинге постепенно обесценивается то, что легко сгенерировать:
— универсальные экспертные статьи;
— шаблонные LinkedIn-посты;
— SEO-тексты без собственного исследования;
— пересказы чужих материалов;
— «10 советов», собранные из уже существующего контента.
По политике Google о scaled content abuse проблемой считается массовое создание контента без дополнительной ценности для пользователя — независимо от того, использовался ли при этом ИИ.
Поэтому в 2026 году скорость создания текста становится менее значимым преимуществом, а оригинальные данные и собственный опыт — более ценным активом.
Что становится конкурентным преимуществом
1. Реальный опыт
Кейсы, собственные исследования, интервью, результаты проектов, реальные цифры и наблюдения.
2. Человеческая экспертиза
ИИ может собрать материал. Но эксперт должен проверить факты, добавить контекст, оспорить очевидные выводы и сказать то, чего нет в исходных данных.
3. Первичные данные
Собственная статистика компании, исследования рынка, опросы клиентов, результаты экспериментов и уникальные datasets становятся особенно ценными.
4. Оригинальная точка зрения
Если один и тот же запрос одинаково хорошо обрабатывают тысячи компаний с помощью ChatGPT, ценность типового текста падает. Преимущество даёт то, что компания знает из собственного опыта и чего не знают остальные.
Вывод
ИИ не отменяет контент-маркетинг. Он обесценивает контент, который можно бесконечно воспроизводить без добавленной ценности.
Чем больше синтетического контента появляется в цифровой среде, тем выше ценность человеческого опыта, первичных данных, оригинальных исследований и настоящей экспертизы.
Главный актив цифрового маркетинга 2026 года — способность создавать информацию, которая возникает из собственного опыта и ещё не стала частью массового цифрового контента.
*Подготовлено RD media*
Похожие материалы
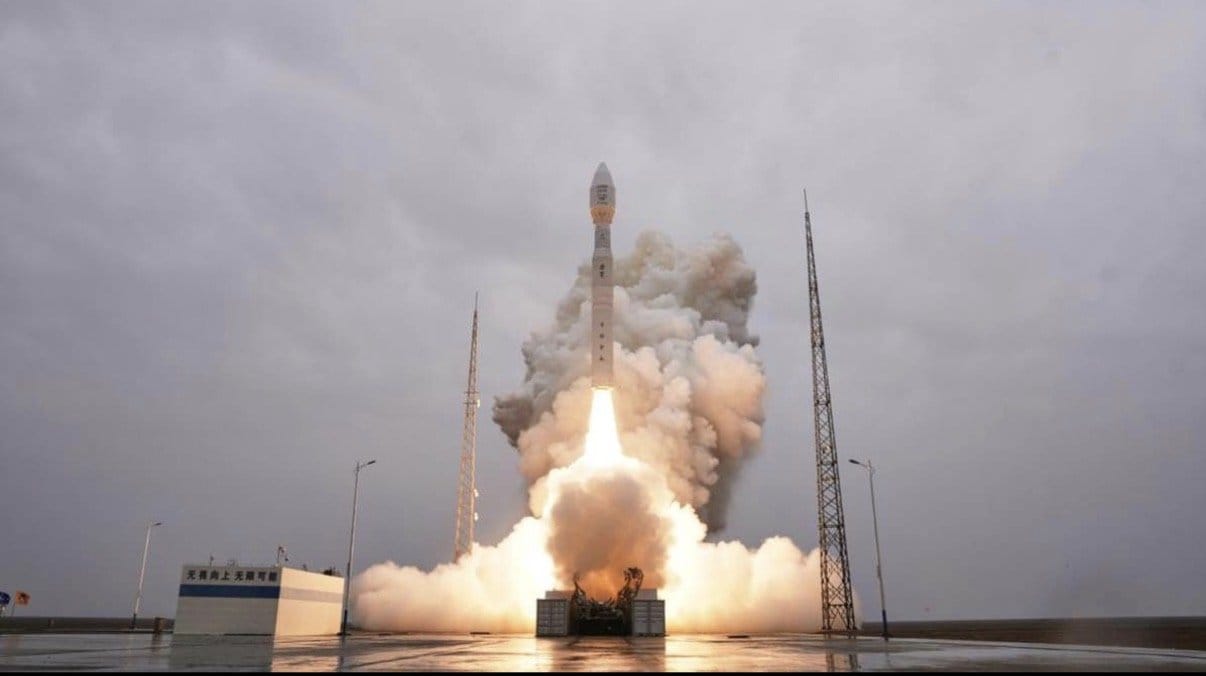
Космос становится инфраструктурой: Китай выполнил шесть запусков за шесть дней
сент. 22, 2026
Звонок без имени: почему защиту от мошенников нельзя откладывать на 2027 год
сент. 22, 2026
JPMorgan: у биткоина потенциал роста выше, чем у золота
сент. 22, 2026