авг. 27, 2026
Модельді бейімдеу: промпттан fine-tuning-ке дейін
Деректер қосылды, бірақ модель жалпы стильде жауап береді. Бейімдеу иерархиясын талдаймыз: промпт пен RAG-тен fine-tuning, LoRA және PEFT-ке дейін....
авг. 26, 2026
Data: модельге жады қалай беруге болады
Модель өте ақылды бола тұра, компания туралы ештеңе білмеуі мүмкін. RAG, embeddings, vector DB және chunking: ЖИ-ға компания біліміне қолжетімділік беру....
авг. 25, 2026
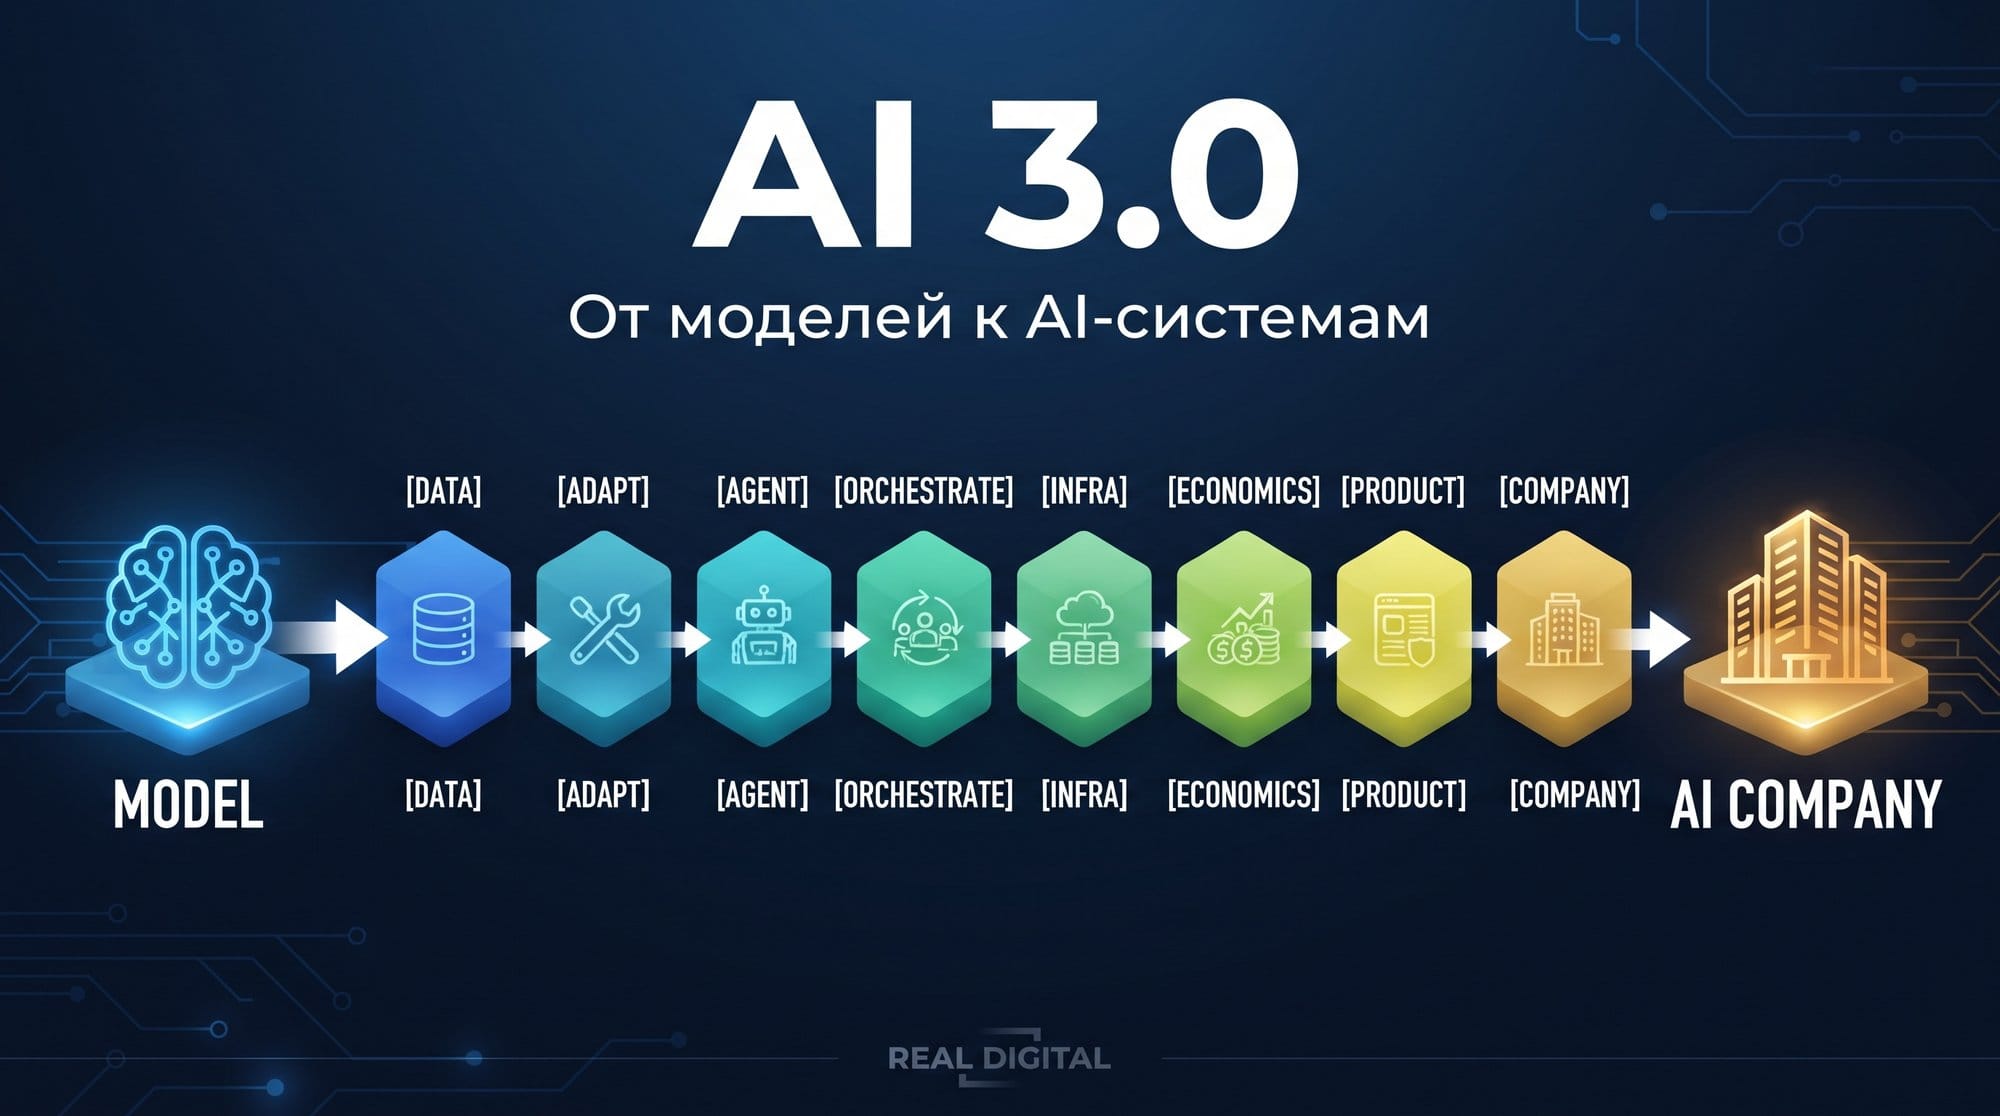
AI Stack: шешім қабылдау картасы
AI-өнім — модель емес. Неден бастау керектігін қарастырамыз: API, меншікті inference немесе edge, сондай-ақ AI жүйесінің 8 блоктан тұратын картасы қалай құрылған....

авг. 06, 2026
Модель мәтін мазмұнын қалай түсінеді: Attention механизмі
2017 жылғы «Attention Is All You Need» мақаласы GPT-тен Claude мен DeepSeek-ке дейінгі дерлік барлық заманауи LLM негізіне жатты. Attention механизмін талдаймыз....
авг. 05, 2026
Mixture of Experts деген не және неге алып модельдер жылдамырақ жұмыс істейді
DeepSeek-V3 моделінің 671 млрд параметрі бар, бірақ әр токенге небәрі 37 млрд-ы жұмыс істейді. Mixture of Experts архитектурасын талдаймыз....
авг. 04, 2026
Модельдерді дистилляциялау деген не және кіші модельдер неге ақылдырақ бола түсуде
Модельдерді дистилляциялау деген не? Үлкен модельдің білімі шағын модельге беріледі — 1,5 млрд параметрі бар модель математикадан GPT-4o-дан озып кетеді....