Бумажные книги стали сырьём для ИИ: что нашли на складе Amazon в Лас-Вегасе
Подготовлено RD media
Кратко: 404 Media проследило партию редких книг с AirTag до склада Amazon, где переплёты срезают, а страницы сканируют. Схему раньше использовала Anthropic. Тексты, которых нет в интернете, стали стратегическим ресурсом для развития ИИ.
Журналисты 404 Media спрятали Apple AirTag в одну из книг партии примерно из 1 000 экземпляров и проследили её маршрут. Маячок привёл на склад Amazon в Лас-Вегасе, где книги разбирают, срезают переплёты и сканируют страницы.
Расследование, опубликованное в августе 2024 года, связало операцию с подготовкой данных для обучения ИИ. Amazon не подтвердила назначение именно этой операции.
Внутри VGT3
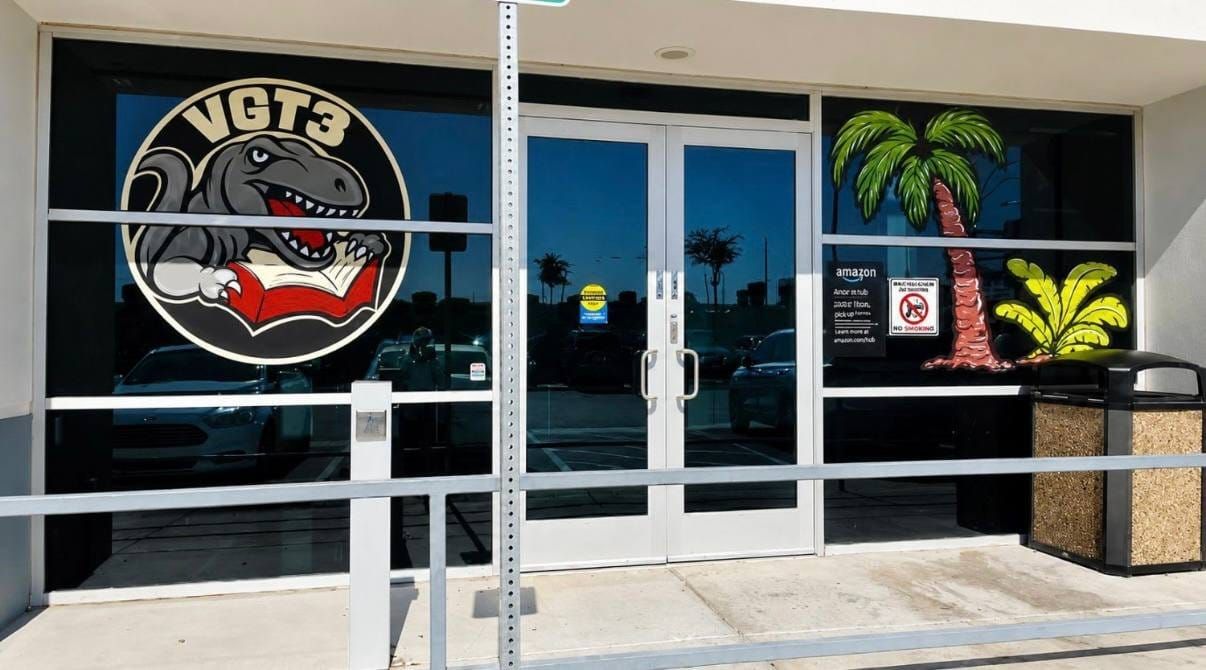
Заказ поступил через маркетплейс Biblio. Отслеживаемая книга прошла через Калифорнию, Висконсин и Колорадо, прежде чем оказаться на складе Amazon LAS8. В северной части объекта работает подразделение VGT3. Его эмблема — тираннозавр с книгой в лапах.
Сотрудники описывают процесс как конвейер: принять партию, срезать корешки, отсканировать страницы. После этого восстановить книгу в первоначальном виде уже нельзя.
Книготорговцы подозревали, что ИИ-компании закупают издания по ISBN, чтобы систематически собирать тексты. 404 Media нашло подтверждения этой версии: сотрудники склада сканируют штрихкоды и ISBN перед обработкой книг.
Amazon заявила, что приобретает книги через коммерческие каналы для развития продуктов и сервисов. Компания не подтвердила, что именно эта операция предназначена для обучения ИИ, и не раскрыла объёмы обработки.
Почему компаниям нужны бумажные книги
В открытом интернете нет всех опубликованных текстов. Старые, редкие и специализированные издания могут содержать материал, отсутствующий в цифровых коллекциях. Для разработчиков моделей такие тексты — ценный источник данных, включая научные и узкоспециализированные материалы.
Проблема не ограничивается количеством данных. Если конкурирующие модели обучаются на похожих открытых источниках, доступ к уникальным материалам может стать преимуществом. Бумажные книги позволяют находить тексты, которые не представлены в обычных цифровых архивах.
Но при таком подходе содержание отделяется от самого издания. Текст может сохраниться в цифровом виде, тогда как оформление, пометки владельцев и история конкретного экземпляра исчезают. Полученная цифровая копия также не обязательно становится доступной читателям.
Anthropic уже прошла этот путь
В рамках Project Panama компания Anthropic организовала масштабную оцифровку книг с уничтожением оригиналов. В материалах судебного процесса цель проекта описывалась как попытка «деструктивно отсканировать все книги мира» — эта формулировка фигурировала в предложении подрядчика, который также планировал обработать от 500 тыс. до 2 млн книг за шесть месяцев.
В июне 2025 года в деле Bartz v. Anthropic федеральный суд США признал обучение ИИ на законно приобретённых книгах добросовестным использованием (fair use). Отдельно в сентябре 2025 года Anthropic согласилась выплатить $1,5 млрд по мировому соглашению о претензиях, связанных с использованием пиратских копий. Это разные правовые вопросы: решение об обучении на законно приобретённых произведениях не легализует незаконное получение книг.
Что это означает для Казахстана
KazLLM обучена на 148 млрд токенов на казахском, английском, русском и турецком языках. В подготовке казахского языкового корпуса участвовали более 140 учёных и сотрудников 26 научных организаций. Материалы собирали по 115 областям знаний.
В Казахстанской национальной электронной библиотеке насчитывается 86 315 документов, включая более 10 тыс. оцифрованных рукописей и редких книг. Электронный фонд доступен читателям, а документы представлены на десятках языков.
Данных о массовой скупке казахских изданий иностранными компаниями нет. Однако сама логика рынка очевидна: текст, который существует только на бумаге, может представлять ценность для разработчиков языковых моделей.
Казахстану важно понимать, какие национальные тексты уже оцифрованы, какие остаются вне цифровых коллекций и на каких условиях они могут использоваться для обучения ИИ. От этого зависит, сколько казахского наследия войдёт в будущие модели ИИ.
Вывод
Тексты, которых нет в интернете, стали стратегическим ресурсом для искусственного интеллекта. Без системной национальной оцифровки казахские тексты рискуют остаться вне контроля государства при использовании для обучения моделей.
Для Казахстана оцифровка — это сохранение наследия и одновременно участие в создании технологий, которые будут работать с казахским языком.
FAQ
Что обнаружило расследование 404 Media?
Журналисты отследили книгу с AirTag до склада Amazon в Лас-Вегасе, где сотрудники срезают переплёты и сканируют страницы.
Подтвердила ли Amazon, что книги используются для обучения ИИ?
Нет. Компания заявила, что покупает книги через коммерческие каналы для развития продуктов и сервисов, но не подтвердила назначение именно этой операции.
Законно ли сканировать книги для обучения ИИ?
В США суд признал обучение на законно приобретённых книгах добросовестным использованием в рамках рассмотренного дела. Использование пиратских копий — отдельный правовой вопрос.
Почему это касается Казахстана?
Казахскоязычные книги, особенно редкие и отсутствующие в интернете, могут стать ценным ресурсом для обучения языковых моделей. Важно обеспечить их сохранность, качественную оцифровку и прозрачные правила использования.
Похожие материалы
Стейблкоинами можно платить как обычной картой. Покупатель использует цифровые активы, а магазин получает обычные деньги
нояб. 06, 2026
Доверие к ИИ начинается с проверки его решений
нояб. 06, 2026
Какой ИИ-стек Freedom Telecom использует для анализа клиентских обращений
нояб. 05, 2026