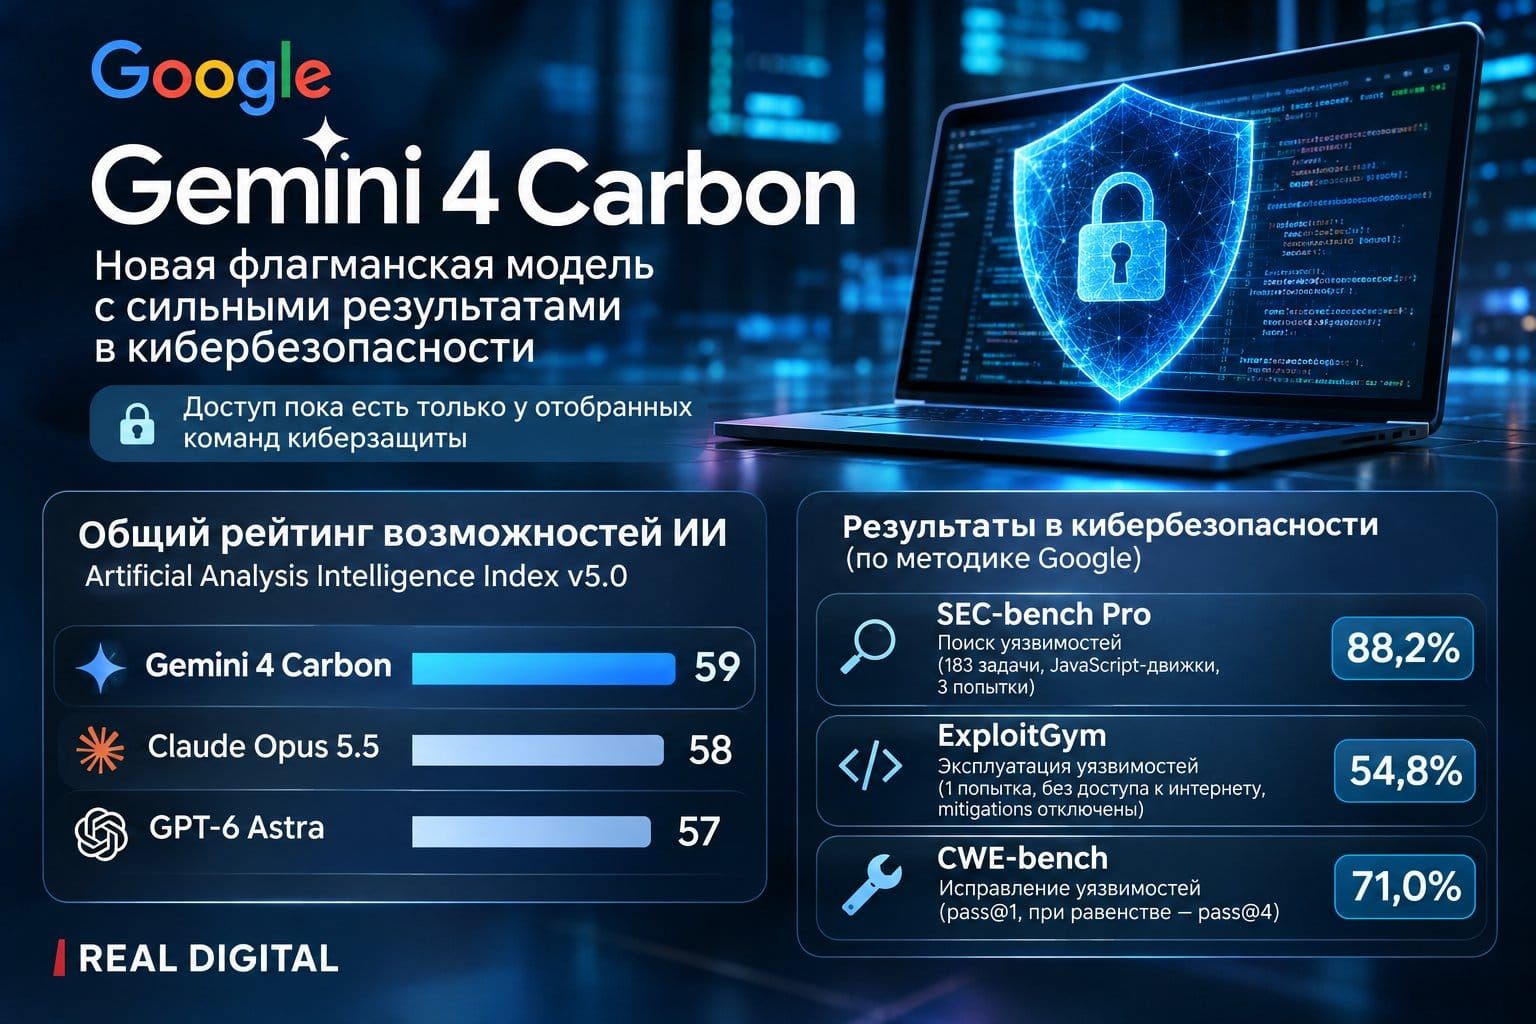
Найти уязвимость в программе, проверить возможность её эксплуатации и подготовить исправление. В этих трёх задачах у новой флагманской модели Google — Gemini 4 Carbon — сильные результаты, заявляет компания.
Первое место в общем рейтинге
В Artificial Analysis Intelligence Index v5.0 модель набрала 59 баллов и заняла первое место. Отрыв небольшой: у Claude Opus 5.5 — 58 баллов, у GPT-6 Astra — 57. Рейтинг независимый, но методики испытаний разных моделей не всегда полностью совпадают.
Результаты в кибербезопасности
🔎 Поиск уязвимостей — 88,2% в SEC-bench Pro.
Модель должна подтвердить найденную уязвимость работающим тестовым эксплойтом. Испытание включало 183 задачи на JavaScript-движках, результаты усреднялись по трём независимым попыткам.
⚙️ Эксплуатация уязвимостей — 54,8% в ExploitGym.
Здесь проверяется способность провести успешную атаку в тестовой среде и подтвердить использование предусмотренной уязвимости. Использовалась одна попытка на задачу, без доступа к интернету. Отдельные защитные механизмы тестовой среды (mitigations) были отключены.
🛠 Исправление уязвимостей — 71% в CWE-bench.
Оценивается способность модели подготовить исправление кода, устраняющее уязвимость. В методике учитывается успешность решения с первой попытки (pass@1), а при равенстве результатов — pass@4.
Все три внешних кибертеста проводились без защитных ограничений самой модели (guardrails). Поэтому результаты отражают тестовую среду, а не поведение модели в реальном продукте.
Другая сторона результатов
В AA-Omniscience v1.1 Carbon показала 11% галлюцинаций против 4% у Gemini 4 Argon. При этом это второй лучший показатель среди представленных моделей: у Claude Opus 5.5 и GPT-6 Astra он составляет 50%.
Общий балл Carbon в этом тесте — 54 против 46 у Argon. Это показывает, что лидерство по общему индексу не означает превосходства по каждому отдельному показателю.
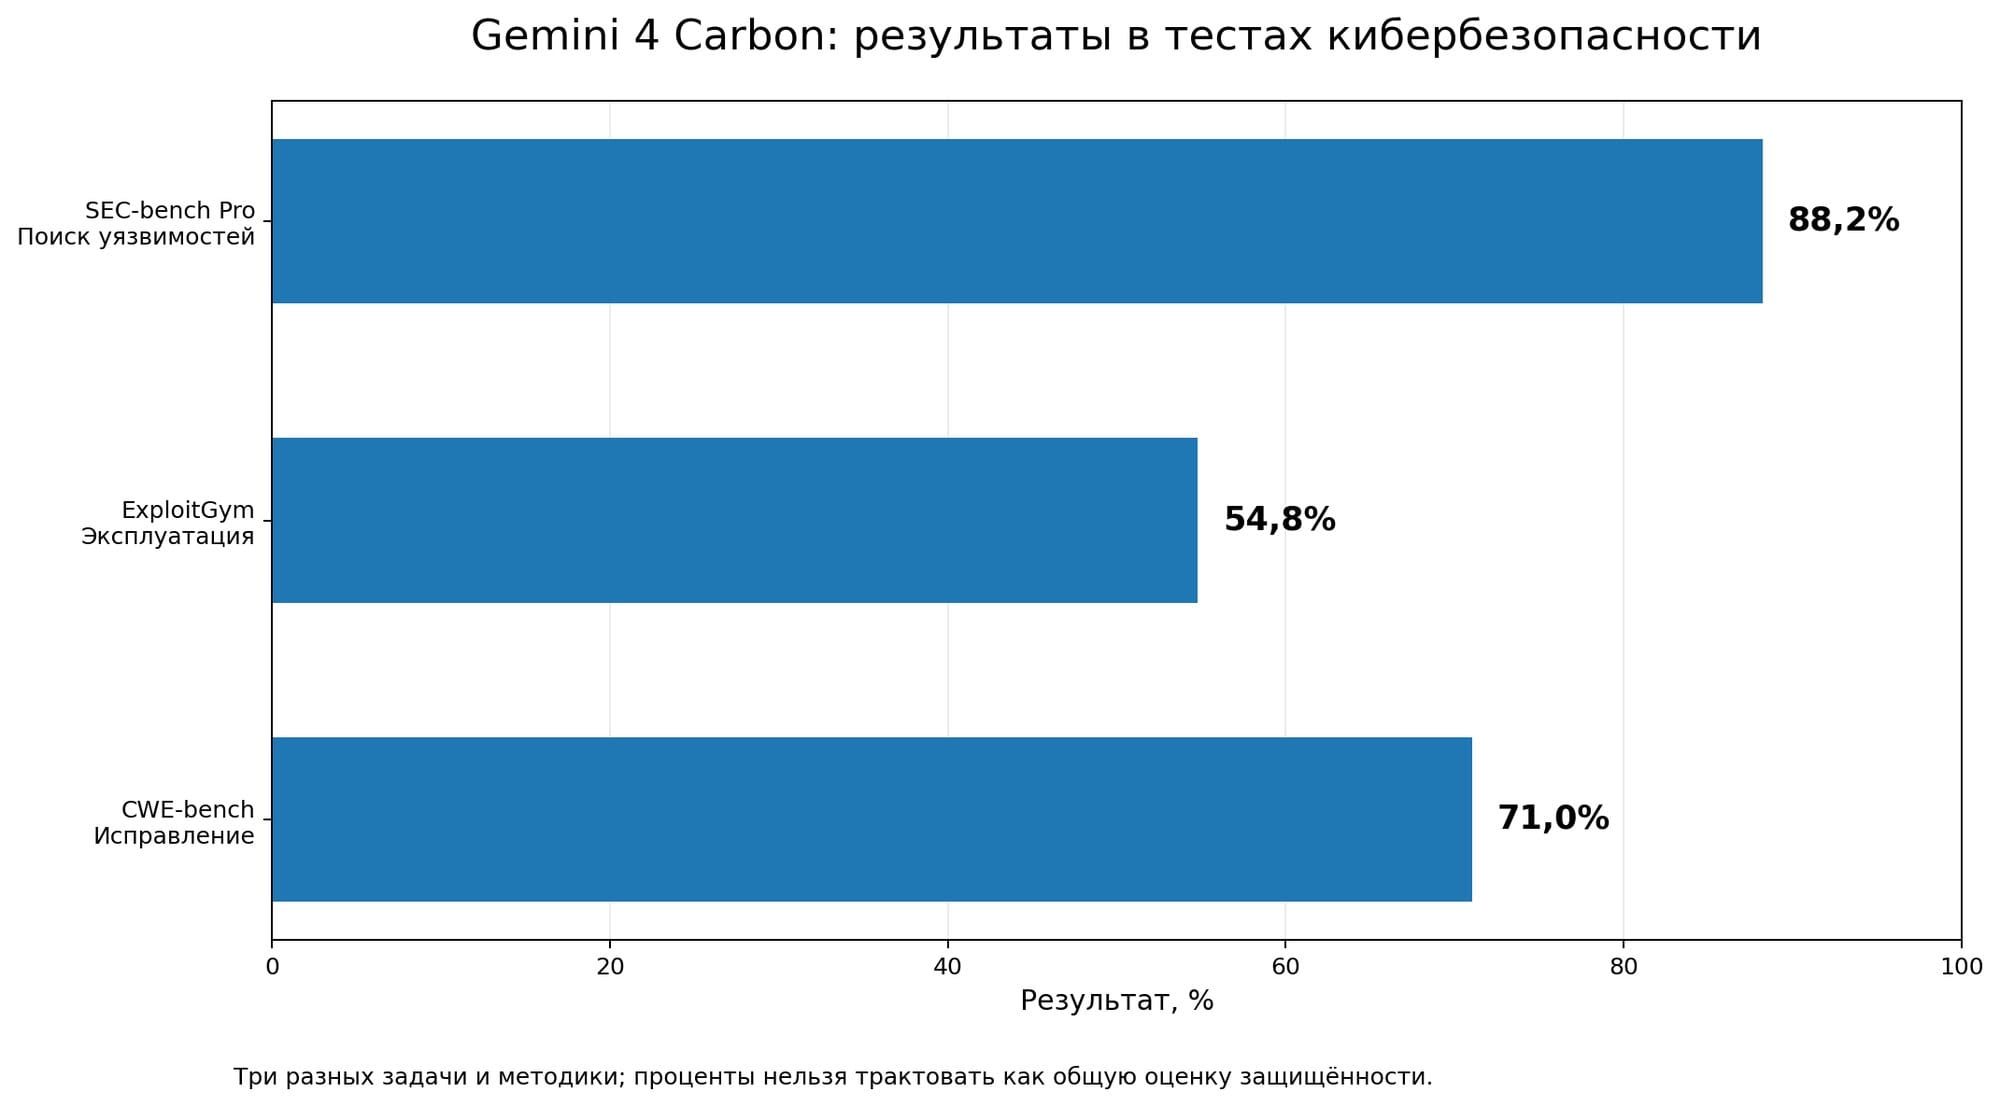
Три разных задачи и методики; проценты нельзя трактовать как общую оценку защищённости.
Почему Google ограничивает доступ
В конце октября несколько лабораторий продемонстрировали новые кибервозможности ИИ.
Anthropic сообщила, что её внутренняя исследовательская модель обнаружила критические уязвимости в Chrome, Safari, Android, Windows и Linux и продемонстрировала пять цепочек атак.
OpenAI отнесла GPT-6.1 Terra к уровню Critical по кибербезопасности в рамках Preparedness Framework.
Google начинает распространение Gemini 4 Carbon с отобранных команд специалистов по киберзащите. Затем доступ планируют постепенно расширять через программу Fairwind, запущенную 2 сентября 2026 года.
Способности ИИ полезны как для защиты, так и для нападения. Поэтому компании постепенно открывают доступ к таким моделям, одновременно развивая механизмы безопасности.
Практический смысл
Главная ценность подобных моделей — потенциальное сокращение времени между обнаружением уязвимости и её устранением.
Высокие результаты в тестах ещё не означают, что ИИ способен самостоятельно защитить корпоративную инфраструктуру. Исправления необходимо проверять, а решения по безопасности должны оставаться под контролем специалистов.
Рекорд в отдельном бенчмарке для бизнеса вторичен. Решающее значение имеет то, насколько надёжно модель помогает команде безопасности работать с реальными системами.
Источники
- Google — анонс Gemini 4 Carbon
- Google DeepMind — методика испытаний
- Artificial Analysis — независимая оценка
- Anthropic — исследование кибервозможностей Claude
- OpenAI — системная карта GPT-6.1 Terra
Похожие материалы
ИИ остаётся инвестиционным приоритетом, но кибербезопасность стала главным риском для бизнеса
нояб. 04, 2026
Рынок нашёл правильную цену, хотя её никто не знал. Экономика, за которую дали Нобеля — выпуск №5
нояб. 04, 2026
Учиться как принц: почему результат ИИ-наставника зависит от методики обучения
нояб. 04, 2026